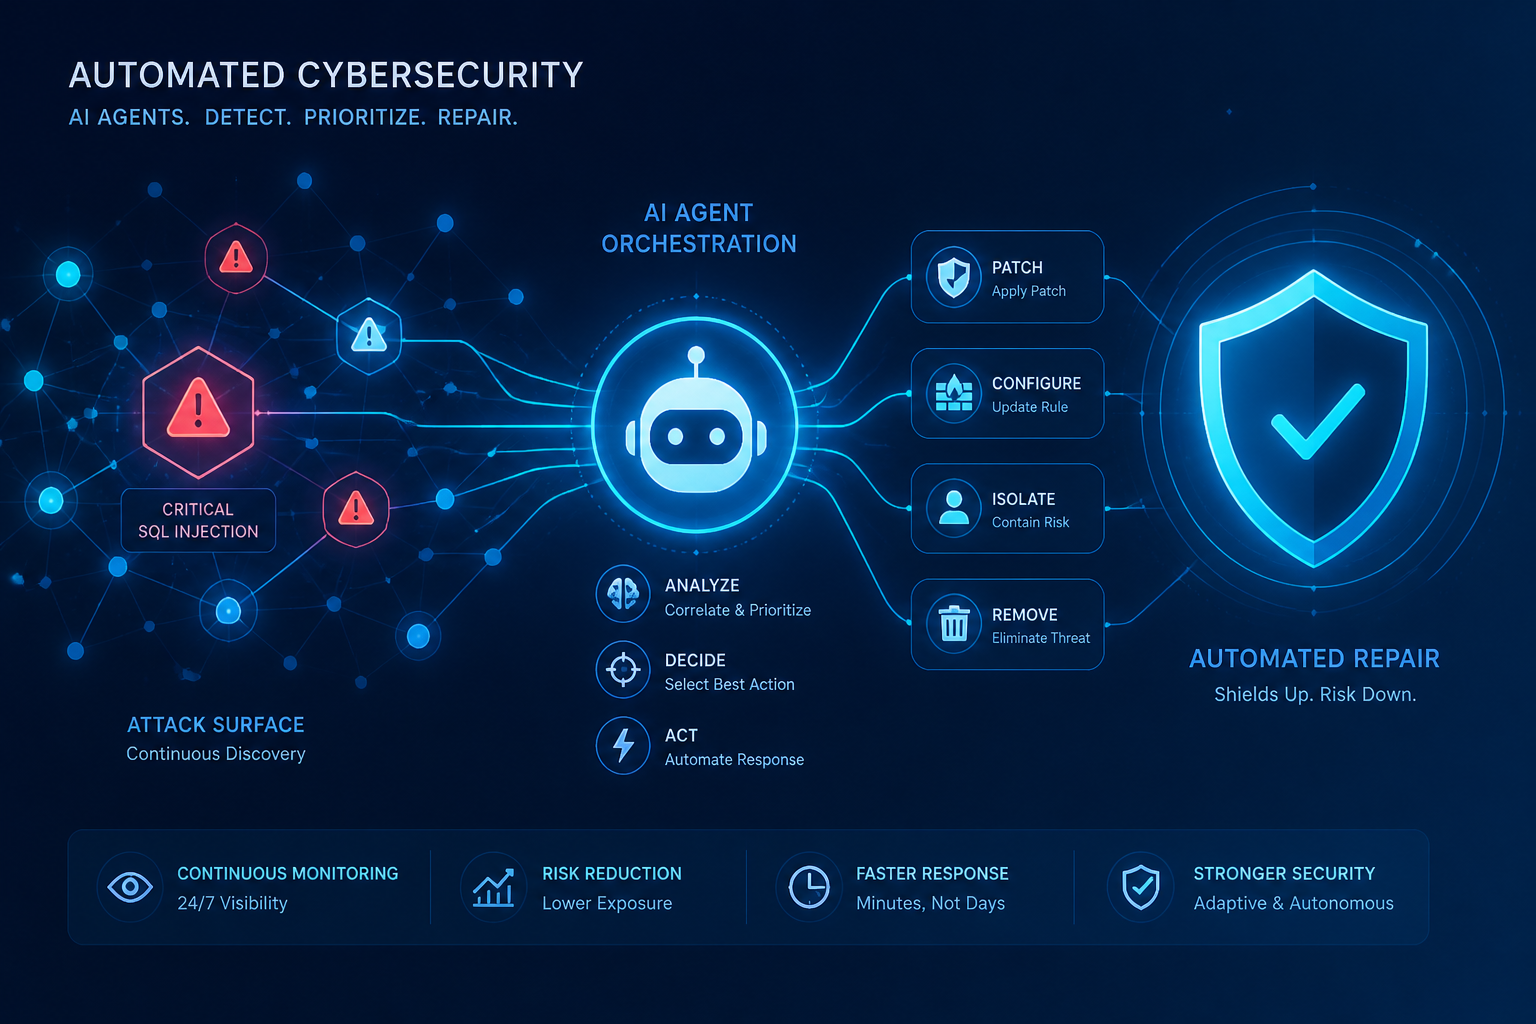
概要:何ができると言われているの?
近年、AIを活用して「脆弱性の検出」から「自動での対処(修復や設定変更)」までをワンストップで提供するマネージドサービスが注目されています。初心者向けに言うと、運用側の負担を減らし、取りこぼしを減らすことを目的にしたサービス群のことです。
マネージドサービスのイメージ(初心者向け)
マネージドサービスとは?
マネージドサービスは、専門ベンダーが監視や運用を代行するサービスです。自社で全てを管理するのではなく、外部のチームやツールに任せる形になります。
AIでの「検出→自動対処」とは?
- 検出:AIがログやスキャン結果、設定情報などから脆弱性の兆候を見つける。
- 自動対処:検出に応じて事前定義した修復手順を自動で実行する(パッチ適用、設定変更、サービス再起動など)。
ただし、実際の詳細はサービスによって異なり、報道や提供会社の発表に基づく情報の確認が必要です。
導入で期待できるメリット
- 対応速度の向上:人手での発見・対応より早く処理できる可能性があります。
- 運用負荷の軽減:日常的な検出・初動対応を外部に任せられるため、社内工数を減らせることが期待されます。
- 24/7の監視がしやすい:常時監視と自動化で見逃しを減らす効果が期待されます。
- スケーラビリティ:環境が大きくなっても一定の対応品質を保てる可能性があります。
ただし、これらは一般的に期待されうる効果であり、実際の効果はサービスの品質や設定次第です。
導入時に想定されるリスク・注意点
- 誤った自動対処による影響:誤検出や誤った修復でサービス停止や不具合が発生する可能性があります。特に本番の重要サービスでは段階的な適用が重要です。
- 誤検知(False Positive)や見逃し(False Negative):AIの検出精度に依存するため、必ずしも完璧ではありません。検出精度はベンチマークで確認しましょう。
- 依存とベンダーロックイン:運用を外部に任せることで、後の変更や移行が難しくなる可能性があります。
- データ取り扱い・プライバシー:ログや設定情報を外部に預ける場合、扱い方を確認する必要があります。
- 説明可能性(Explainability)の不足:AIがなぜその判断をしたのか分かりにくい場合があります。説明出力やログの粒度を確認しましょう。
導入前に確認する7つのポイント
-
検出精度と評価方法
ベンダーにどのように精度を評価しているか確認します。具体的には混同行列(True Positive/False Positive/True Negative/False Negative)、指標としてTPR(Recall)、FPR、Precision、F1スコアなどを提示してもらいましょう。例としてベンチマークの“例示値”を示すと比較がしやすく、参考例として「TPR=0.8〜0.95、FPR=0.01〜0.2、F1>0.7」などの範囲を自社要件に応じて検討します(業界・ケースで異なります)。
ベンチマーク方法のサンプル手順:
- 対象範囲と評価データセットを定義(過去のログや脆弱性事例を含む)
- データにラベル付け(既知脆弱性/正常事象)を行う
- ベンダーの検出を実行し、結果とラベルを突合して混同行列を作成
- TPR/FPR/Precision/F1を算出し、閾値やしきい値の調整性を確認
- 実運用のパイロットで再評価(本番に近いデータで99%近い再現性が出るか確認)
-
自動対処の範囲と制御方法
どの範囲まで自動化されるのか(提案のみ/自動実行/承認制)を明確にしましょう。以下のような具体的設定を確認します:自動実行対象の操作一覧、リスク分類(低・中・高)に応じた実行ルール、承認フローとロールバック手順の有無、ステージングやカナリア実行の可否。
-
可視化・ログと監査トレイル
検出・対処の履歴が取得できるか、説明可能なログや変更履歴が残るかを確認してください。具体的には実行前後の差分ログ、AIの判断理由(confidenceスコアや説明文)、誰がいつ承認したかの監査記録があることが望ましいです。
-
テスト環境での検証/段階的導入
まずは非本番環境で試験できるか、段階的に導入して影響を評価できるかを確認します。パイロットでは低リスク領域→限られた本番ターゲット→フル展開、という段階的な進め方を推奨します。
-
データ保護とアクセス権限
ログや設定データの取り扱い、保存場所、暗号化、ベンダーのアクセス権限を確認します。法令・規程遵守やデータ所在(リージョン)、第三者アクセスの開示を要求しましょう。
-
SLA・責任分界(責任範囲)
インシデント時の責任範囲、SLA(復旧時間や対応時間)、誤った自動対処で生じた被害の責任所在を契約で明確にしておきましょう。具体項目例:RTO(復旧時間目標)、RPO(許容データ損失)、賠償範囲、通知体制。
-
既存ツールとの連携と運用体制
既存の監視ツールやチケットシステムと連携できるか、社内の運用ルールとの整合性、担当者の教育体制を確認します。エスカレーション手順やロールと権限(例:Operator/Approver/Auditor)を事前に設計してください。
チェックリスト(ベンダー確認テンプレ)
- 検出精度の指標提示(TPR/Precision/F1等)と実測データの提供可否
- 誤検知・見逃しの具体例と対処状況の事例
- 自動実行の対象操作一覧(パッチ適用/再起動等)とリスク分類
- 承認フロー(自動実行/承認制のルール)とロールバック手順
- ログの粒度(判断理由、confidence、影響範囲の表示)と保持期間
- データ保存場所(リージョン)、暗号化、アクセス権限の設計
- SLA項目(RTO/RPO、通知時間、対応時間)と責任分界
- 既存ツール連携(SIEM/ITSM/チケット連携)の方式とAPI仕様
- 試験・パイロットの範囲と退出条件(停止基準)
- 見積り内訳(ライセンス、導入・統合作業、運用サポート時間)
実例・ケーススタディ(短い想定事例)
事例A(パイロットでの誤対応想定): 小規模サービスで自動パッチ適用を本番にそのまま適用したところ、パッチが特定構成に非対応でサービスが再起動不能になった。対処:①即時ロールバック(スナップショットから復旧)、②問題の原因分析、③自動実行ルールを見直し、該当操作を承認制に変更。学び:本番は必ず段階的にし、重要操作は承認制にする。
事例B(誤検知の運用改善): AIが一定の通信パターンを脆弱と判定し多くのFalse Positiveを出した。対処:検出条件のチューニング、ホワイトリスト化、運用ルールで『初動は提案のみ』に変更。学び:監査ログと例示データを使った継続的なチューニングが重要。
技術的背景(簡易説明)
AIによる検出は大きく分けてルールベース(シグネチャや定義ルール)と機械学習(異常検知や分類モデル)があります。ルールベースは分かりやすく誤検出の理由が追いやすい一方、未曾有の事象に弱い。MLは未知のパターン検知に強いが、説明性が低くなることがあります。多くのソリューションは両者を組み合わせたハイブリッドを採用します。
検出に使われうる特徴量の例:CVEマッチング、設定値の逸脱(config drift)、ポートやプロトコルの異常な通信、ログ内のエラーパターン、脆弱なライブラリのバージョン情報など。Explainability対策としては、判断ごとにconfidenceスコアや『なぜ該当したか』の要約を出力する機能、影響範囲の可視化、詳細な実行ログを残す設計が有効です。
運用面の詳細(権限設計・承認フロー例)
ロール例と権限:
- Operator:検出結果の確認、低リスク修復の実行権限
- Approver:中リスク以上の自動実行承認者(1名以上)
- Change Manager:重大変更やスケジュール調整の最終承認
- Auditor:ログ確認・監査用の読み取り権限
承認フロー例(リスク別):
- 低リスク(設定の軽微な変更等):自動実行可(通知あり)
- 中リスク(再起動を伴う変更等):検出→提案→1名のApprover承認→実行
- 高リスク(データベース停止、構成の大幅変更等):検出→提案→2名以上の承認+メンテナンスウィンドウで実行
コンプライアンス・コスト面の考慮
データ所在や個人情報の取り扱い、越境データ規制に注意してください。契約時にデータの保管リージョン、暗号化方式、第三者アクセスの可否を明確にしましょう。また想定コスト要素は、ライセンス費用、初期統合作業、パイロット費用、運用・監視の工数、ベンダーのサポート時間などです。コストは導入規模や既存ツールとの連携状況で変動します。
導入を進める際の実践的な進め方
- まずは小規模なパイロットで効果とリスクを評価する(低リスク領域から段階的に拡大)。
- KPI(検出率、誤検知率、平均対応時間、手動対応工数削減など)を設定して定期的にレビューする。
- 自動対処は段階的に拡大し、重大な操作は承認フローを残すなど運用ルールを定める。
- ベンダーと共同で障害時のリカバリ手順を作り、定期的に訓練する。
- 定期的に検出モデルやルールをレビューし、誤検知の傾向や新たな脅威を反映する。
視覚的要素と社内リンク(提案)
理解を早めるために「検出→判定(スコア)→対処(承認/自動)→監査」のフローチャートを作成するとよいです。社内文書へのリンク例(存在する場合):/docs/security/auto-remediation-flow、ポリシーページ:/policies/security。これらが無ければ導入に合わせて作成してください。
まとめ
AIを活用した「脆弱性検出→自動対処」をうたうマネージドサービスは、運用効率化や迅速な対応に役立つ可能性があります。一方で自動化に伴うリスクや責任の所在、検出精度などを事前に慎重に確認することが重要です。具体的な指標(TPR/FPR/F1など)で比較し、パイロットで実際の挙動を検証した上で段階的に導入することをおすすめします。
参考情報
NEC、フロンティアAIを活用し、脆弱性の検出から対処までをワンストップで支援する自律型マネージドサービスを提供開始 — NEC
DatadogがAIエージェント時代の運用基盤を強化、自律型「Bits AI」で検知から修復まで自動化 — CodeZine
※この記事には広告が含まれています。
関連するおすすめサービス
Webサイトを運営する場合は、改ざんやマルウェアへの備えも検討しておきましょう。

コメント