はじめに
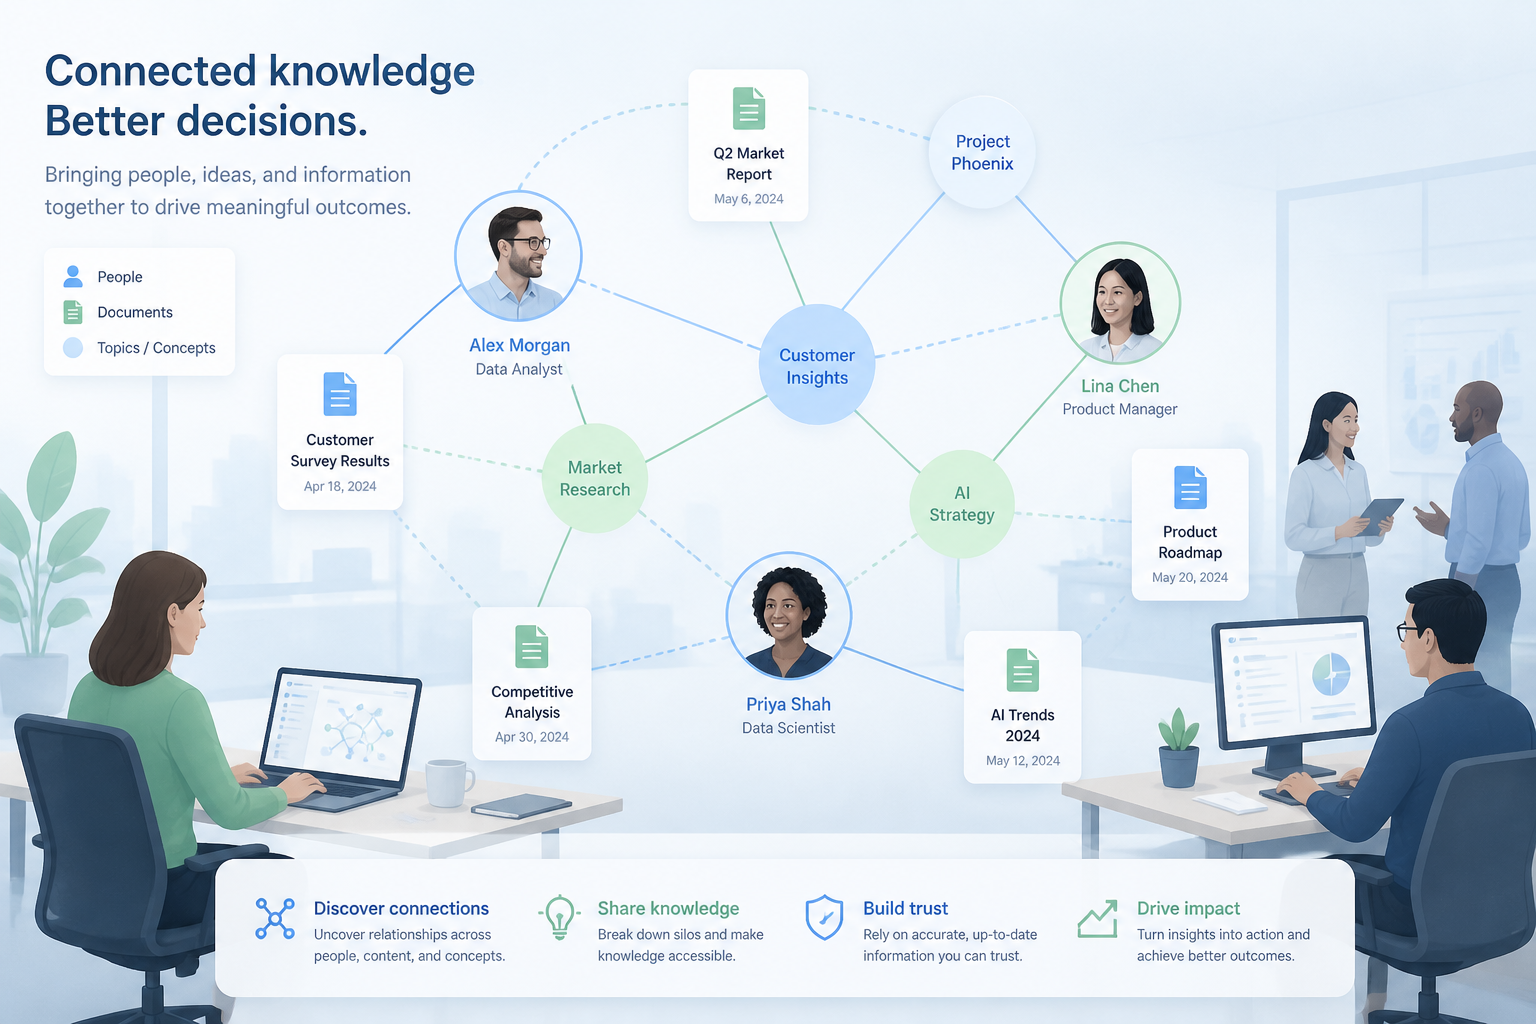
部署に蓄積された「属人知(個人に依存する知見)」は、業務効率化や意思決定の質向上に役立つ重要な資産です。初心者がオントロジーとナレッジグラフを使ってこれをAIで活かすには、知見を人にしかわからない状態からデータ化し、検索・推論・可視化できる状態にすることが必要です。本記事は「初心者 オントロジー ナレッジグラフ 使い方」を意識し、実務で使えるテンプレート、コード例、ツール選定、PoCスケジュールやKPI目安、セキュリティ対策まで具体的にまとめます。
全体の流れ(5ステップ)
大まかな流れは次の5つです。準備→収集→設計→構築→運用。各ステップに実践的なテンプレートと具体例を付け、初心者でも着手できるようにしています。
ステップ1:目的とスコープの定義(準備)
まずはなぜ知見をデータ化するのか、成功の定義(KPI)を明確にします。目的がぶれると現場の負荷だけが増えるため、KPIやスコープは実現可能な範囲で決めます。
- 対象部署・業務プロセスを絞る(例:問い合わせ対応、審査手続き、契約レビュー)
- 期待する効果を定量化する(例:検索時間を30%短縮、FAQ解決率を70%に引き上げる、一次回答率を50%→75%など)
- 関係者(現場の担当者=SME、プロダクトオーナー、IT担当、ガバナンス担当)の役割を決める
KPI例と測定方法(サンプル):
- 検索時間短縮:平均検索セッション時間をベースライン(t0)で測定し、PoC終了後(t1)で%短縮を算出。目標値: -20〜40%(PoCフェーズ)
- FAQ解決率:チャットボットやFAQでの初回解決率。ベースラインを測り、改善目標は +20ポイント(例:50%→70%)
- 応答精度(QAモデル):Precision@1やTop-3の正解率を評価。PoC終了時の目安: Precision@1 70%超が実務利用の目安
ステップ2:情報の収集とデジタル化
紙や口頭で存在する知見を、できるだけ構造化して集めます。主要ソースはドキュメント、メール履歴、FAQ、インタビュー音声・議事録などです。
- ヒアリングはテンプレート(状況、判断基準、例外、根拠、参照資料)を用意して実施する
- 既存ドキュメントはメタデータ(作成者、日付、対象プロセス、信頼度)を付与して保存する
- 逐次的にデータ化し、小さな範囲で試す(PoC)ことを検討する
ヒアリングテンプレート(例)
- 担当者名(SME)/役割
- 業務の目的(何を達成するか)
- 典型的な手順(ステップバイステップで記載)
- 判断基準(何をもってOK/NGとするか)
- 例外ケースとその対処方法
- 参考文書・リンク(社内規程、様式)
- よくある誤り/注意点
メタデータ項目一覧(保存時の推奨項目)
- document_id, title, author, created_date, updated_date
- department, process, source_type(document/email/interview)、confidentiality_level
- confidence_score(SME評価)、annotator, provenance_url
注意:個人情報や機密情報を扱う場合は社内規程と法令を必ず確認してください。次に示すセキュリティ対策テンプレートを運用に組み込みます。
ステップ3:オントロジーの設計(概念モデル作成)
オントロジーは業務で使う主要な概念(クラス)と関係性(プロパティ)を定義する設計図です。初めはコアな概念だけでよく、運用で拡張します。ここに簡単なTTL(Turtle)例を示します(入門レベル)。
@prefix ex: <http://example.com/ontology#> .
@prefix rdf: <http://www.w3.org/1999/02/22-rdf-syntax-ns#> .
@prefix rdfs: <http://www.w3.org/2000/01/rdf-schema#> .

ex:Customer a rdfs:Class .
ex:Case a rdfs:Class .
ex:Document a rdfs:Class .

ex:hasCase a rdf:Property ;
  rdfs:domain ex:Customer ;
  rdfs:range ex:Case .

ex:relatedDocument a rdf:Property ;
  rdfs:domain ex:Case ;
  rdfs:range ex:Document .

ex:status a rdf:Property ;
  rdfs:domain ex:Case ;
  rdfs:range rdfs:Literal .
この断片は、”Customer”→”Case”→”Document”の基本的なつながりを示しています。実務では用語集を作り、SMEと合意を取りながら定義を固めます。
オントロジー設計テンプレート(実務)
- 目的(このオントロジーで何を表現するか)
- コアクラス(最大10個程度でスタート)と説明
- 重要プロパティ(domain, range, cardinalityの想定)
- サンプルインスタンス(ユースケースごとの事例)
- バージョン管理と変更ルール
ポイント:すべてを厳密に定義する必要はなく、業務で使いやすいレベルで決め、運用しながら改善するのが現実的です。
ステップ4:ナレッジグラフへの実装(データ化と統合)
オントロジーをもとに、収集した情報をナレッジグラフにマッピングします。ナレッジグラフはノード(エンティティ)とエッジ(関係)で表現され、検索や推論に有利です。
ナレッジグラフのノード・エッジの具体例
- ノード例: Customer(ID: C123, name: 株式会社A)
- ノード例: Case(ID: K456, status: 審査中, created_date: 2025-05-10)
- エッジ例: (Customer C123) -[hasCase]-> (Case K456)
- エッジ例: (Case K456) -[relatedDocument]-> (Document D789)
簡易的なJSON形式のサンプル(概念説明用):
{
  "nodes": [
    {"id": "C123", "type": "Customer", "name": "株式会社A"},
    {"id": "K456", "type": "Case", "status": "審査中"}
  ],
  "edges": [
    {"from": "C123", "to": "K456", "relation": "hasCase"}
  ]
}
ツールと技術スタック例(用途別おすすめ)
- グラフDB(プロダクション向け): Neo4j(操作性・クエリが学びやすい)、JanusGraph(スケーラブル)
- RDFベース/トリプルストア: GraphDB、Blazegraph(RDF/OWLを使う場合)
- クエリ言語: SPARQL(RDF系)、Cypher(Neo4j)
- ETL・連携: Apache NiFi、Kettle、カスタムPython ETL(pandas + rdflib)
- 検索・QA: Elasticsearch + 融合ソリューション(RAGやRetrieval系)
- アノテーション: Prodigy、Label Studio(手動タグ付け用)
実務では、既存のシステム連携の容易さ、チームのスキル、予算を勘案して選びます。
ステップ5:運用と改善サイクル
構築したナレッジグラフを業務で使い、フィードバックを得て改善します。継続的なメンテナンスとガバナンスが成功の鍵です。
- 利用シナリオ(検索、チャットボット、レコメンド、レポーティング)を優先順位付けする
- 現場からのフィードバックを収集し、オントロジーとデータを定期的に更新する
- 所有者(データオーナー)と更新ルールを定め、古い情報の整理を行う
運用ルール雛形(例)
- データオーナー:各部署に1名。変更申請はPull Request方式で管理。
- 更新頻度:コアオントロジー 3ヶ月毎のレビュー、コンテンツは毎月差分チェック。
- 品質レビュー:重要変更はSMEによる承認必須。自動テスト(整合性チェック)をCIに組み込む。
- ログと監査:作成/更新/削除イベントをログに記録、保持期間は社内ポリシーに従う(例:1年)。
PoC/導入スケジュールと工数感(目安)
最小構成PoC(対象: 単一プロセス、約1〜3ヶ月):
- スコープ: 1業務プロセス、対象ドキュメント数 100〜500件
- チーム例: PO 0.2〜0.5人月、SME 0.5〜1人月、開発/データエンジニア 1〜2人月、運用担当 0.2人月
- 推奨期間: 4〜8週間(設計2w、データ収集2w、実装2w、評価2w)
- 成果物: 軽量オントロジー、サンプルナレッジグラフ、簡易QA/検索画面、KPI測定結果
段階的な拡張(第2フェーズ)ではスコープ拡大と自動化(ETL、タグ付け自動化)を進めます。
実務的なヒントとよくある落とし穴
- 小さく始めて可視化する:範囲を限定したPoCで効果を見せることが導入成功の近道
- 関係者の合意形成を重視:用語や判断基準のズレが後のコスト増につながる
- ガバナンスを設計:誰が更新するか、どの頻度でレビューするかを明確化する
- 測定指標を設定:検索時間、FAQ解決率、手戻り件数、Precision/Recallなどを定義する
- 過度な自動化の罠:自動タグ付けやNLPだけに頼らず、必ず人のレビューを設ける
初心者向けチェックリスト
- 目的とスコープを明確にした(OK/NG)
- 主要な知見ソースをリストアップした
- 最低限のオントロジーを作成した(クラス×5、プロパティ×10程度)
- 小規模なナレッジグラフで動作確認した
- 運用ルールと担当者を決めた(更新頻度、レビュー責任者)
- KPIと測定方法を定義した(ベースライン取得済み)
セキュリティ・ガバナンスの具体策(実務ルール例)
- 個人情報の取り扱いフロー:収集前にPIIチェックリストを実施。PIIはマスキングまたは別ストアで管理。
- アクセス制御:RBAC(Role-Based Access Control)を導入し、編集/閲覧権限を分離する。
- ログ保存ルール:作成・更新・削除イベントを記録。変更理由と承認者を必須メタデータにする。
- 監査手順:四半期ごとのデータ品質監査と年次コンプライアンスレビューを実施する。
簡易的な匿名化手順(例):
- 1) PIIフィールドを識別(氏名、メール、電話、住所)
- 2) 可能な場合はハッシュ化またはトークン化
- 3) 分析用には集計値のみを用いる(個人を再識別できない形にする)
FAQ(よくある疑問)
- どれくらい厳密にオントロジーを設計すべきか?
業務で使えるレベルから始め、実運用からの変更要求で改善するのが現実的です。まずはコア概念を5〜10個定義しましょう。 - どのデータから手を付けるべきか?
扱いやすく効果が見えやすいドキュメント(FAQ、対応履歴、雛形)から始めるのがおすすめです。 - 外部委託はいつ検討するべきか?
社内に専門人材がいない場合、PoC段階で短期の外部支援を入れてナレッジ移管を計画すると失敗リスクを下げられます。
次の一歩
まずは対象を一つに絞り、インタビュー(テンプレートを利用)と既存ドキュメントの整理から始めてください。PoCのスコープを明確にして、KPIと計測方法を定義したうえで短期間で成果を評価しましょう。外部技術支援を受ける場合でも、業務現場のSMEが中心的役割を担うことが成功条件です。
参考情報
- RDF 1.1 Concepts (W3C)
- OWL 2 Web Ontology Language Overview (W3C)
- Neo4j Documentation
- GraphDB Documentation
- SPARQL 1.1 Overview
- Label Studio(アノテーションツール)
- Elasticsearch(検索基盤)
- MUFGの事例(EnterpriseZine)
必要であれば、上記テンプレートをCSV/Excel形式に落とし込んだサンプルや、上で示したTTL断片の拡張版を提供できます。実運用で迷ったポイントがあれば、具体的な業務プロセスを教えてください。より実践的なアドバイスを差し上げます。
※この記事には広告が含まれています。
関連するおすすめサービス
Webサイトを運営する場合は、改ざんやマルウェアへの備えも検討しておきましょう。

コメント